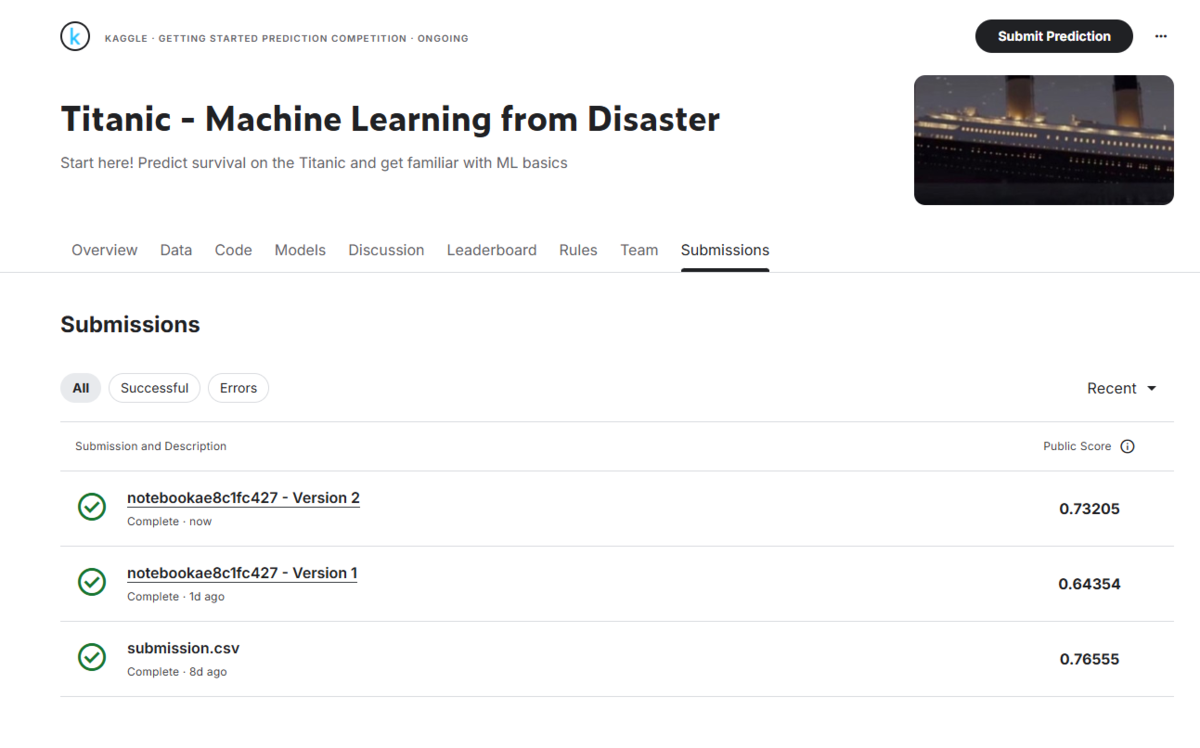
Kaggle少し修正
以下、AIの指摘に従い、特徴量対象項目を増やしたら前回よりはスコアが上がった。
仮説としては有効な特徴量を持つ項目を絞れば、よりスコアが上がるということですね。
#説明変数(特徴量)と目的変数を設定
# 2025/09/26 デフォルト以下の為、特徴量対象項目を変更
# features = ['Pclass','Sex','Age']
features = ['Pclass','Sex','Age','SibSp','Parch','Fare']
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier

#データ読込
train = pd.read_csv('../input/titanic/train.csv')
test = pd.read_csv('../input/titanic/test.csv')

#データ属性表示
#print(train.info())
# 複数列を選択する場合はリストで指定
x_train = train[["Pclass","Fare"]]
print(x_train.shape)

#前処理
#性別を数値化(male:0,female:1)
train['Sex'] = train['Sex'].map({'male':0, 'female':1})
test['Sex'] = test['Sex'].map({'male':0, 'female':1})


#欠損値を埋める(AgeとFareを中央値で埋める)
print('処理前の欠損数')
print(train.isnull().sum())  # Age列の欠損値が中央値で補完されているか確認
print(test['Age'].isnull().sum())  # Age列の欠損値が中央値で補完されているか確認


train['Age'] = train['Age'].fillna(train['Age'].median())
test['Age']  = test['Age'].fillna(test['Age'].median())
test['Fare'] = test['Fare'].fillna(test['Fare'].median())


print('処理後の欠損数')
print(train.isnull().sum())  # Age列の欠損値が中央値で補完されているか確認
print(test['Age'].isnull().sum())  # Age列の欠損値が中央値で補完されているか確認

#説明変数(特徴量)と目的変数を設定
# 2025/09/26 デフォルト以下の為、特徴量対象項目を変更
# features = ['Pclass','Sex','Age']
features = ['Pclass','Sex','Age','SibSp','Parch','Fare']

X = train[features]
y = train['Survived']

#モデル学習
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X, y)

#予測
X_test = test[features]
predictions = model.predict(X_test)

#提出用ファイル作成
output = pd.DataFrame({
    'PassengerId': test.PassengerId,
    'Survived': predictions
})

output.to_csv('submission.csv', index=False)


print("submission.csv出力完了しました!")